Mostrando las entradas con la etiqueta UI. Mostrar todas las entradas

martes, 2 de marzo de 2010

.Net MVC + jQuery: manejo de excepciones. IV: el lado del cliente.

Finalizamos el post anterior de esta serie con la infraestructura necesaria para atrapar en javascript los errores y excepciones que puedan producirse del lado del servidor y “canalizarlos” hacia tipos conocidos con una codificación similar a la que utilizamos en c#.

Recordemos el ejemplo final. Teníamos, en javascript, una excepción base:

ExceptionBase = function (type, message) {
    this.Type = type;
    this.Message = message;
};

De la que luego derivamos dos excepciones más específicas, una para excepciones de negocio (la que arrojaría nuestro código en el caso de que una operación supere cierto monto permitido, por ejemplo):

ProgramException = function (message, netException) {

    this.Reasons = [];
    this.NetException = netException;

    if (typeof message != "undefined" && message != null)
        this.Message = message;

};
ProgramException.prototype = new ExceptionBase("ProgramException", "Operation Error");

y la otra para errores “fatales”, es decir todos aquellos que indican que la aplicación ha arribado a un estado no contemplado y que por lo tanto no puede seguir utilizándose (que ha cascado, vamos):

FatalException = function (message, netException) {
    this.NetException = netException;
    if (typeof message != "undefined" && message != null)
        this.Message = message;
}

FatalException.prototype = new ExceptionBase("FatalException", "Unexpected Error");

Para ver cómo utilizamos estas clases veamos nuestro ejemplo de llamada $.ajax, donde se establece la diferencia entre errores de negocio y fatales, lanzándose una excepción u otra dependiendo el caso. Más concretamente la sección “success” (lo siguiente es sólo el fragmento correspondiente a “success” dentro de la llamada a $.ajax):

  //... (etc) ....

  success: function (response, status, xhr) {

   //Exception handling.
   var responseStatus = xhr.getResponseHeader("RESPONSE_STATUS");
   var ex = null;
   if (responseStatus == "ApplicationException") 
   {
      var netEx = JSON.parse(response);
      ex = new ProgramException(netEx.Message, netEx);
      ex.Reasons = netEx.Reasons;
   }
   else if (responseStatus == "UnexpectedException") 
   {
      var netEx = JSON.parse(response);
      ex = new FatalException(netEx.Message, netEx);
   }

   if(ex!=null)
   {
      if (async)
         ShowException(ex)
      else
         throw ex;     
   }

   //...(continúa)...

Esta infraestructura de excepción base y derivadas sería una complejidad decorativa y sin sentido si no tomamos, en algún lugar del código, una decisión en base a ese tipo que tanto esfuerzo nos lleva determinar.

La diferencia entre una excepción y otra, desde el punto de vista del front-end, radica en cómo se le presenta al usuario. En nuestro ejemplo, esa tarea le corresponde a la función ShowException:

ShowException = function (exception) {
    //non-fatal exceptions
    if (exception.Type == "ProgramException") {
        var $messageBox = GetMessageBox();
        $messageBox.find("#MessageBoxReasons").html(exception.Reasons.join( "<p/>" ));
        var buttons = {};
        $messageBox.dialog({
            autoOpen: true,
            modal: true,
            buttons: { "Ok": function () { $messageBox.dialog("destroy"); } },
            closeOnEscape: true,
            title: exception.Message,
            close: function () { $messageBox.dialog("destroy"); }
        });
    }
    //fatal exceptions.
    else if (exception.Type == "FatalException") {
        var displayHtml = "<h1>" + exception.Message + "</h1>";
        var doc = window.top.document;
        doc.open();
        doc.write(displayHtml);
        doc.close();
    }
}

Esta función simplemente evalúa el tipo de excepción que recibe y toma las decisiones necesarias. En este ejemplo, muy simple y esquemático, tenemos dos secciones: la primera parte del if crea una ventana utilizando $.dialog para mostrar prolijamente las excepciones de negocio, y la segunda parte (luego del else) “rompe” la pantalla, limpiando todo el html y dejando solamente el mensaje de error.

La función auxiliar “GetMessageBox” simplemente construye el html necesario para mostrar el cuadro de diálogo:

GetMessageBox = function () {
    var top$ = window.top.$;

    var $messageBox = top$("#MessageBoxContainer");
    if ($messageBox.length > 0)
        return $messageBox;

    var $messageBoxContainer = top$("<div />").appendTo(top$("body"));
    $messageBoxContainer.attr("title", ""); 
    $messageBoxContainer.css("display", "none");

    var $innerTable = top$("<table/>").appendTo($messageBoxContainer);
    $innerTable.css("width", "100%");

    var $innerTableFirstRow = top$("<tr/>").appendTo($messageBoxContainer);

    var $innerTableFirstRowFirstCell = top$("<td/>").appendTo($innerTableFirstRow);

    var $messageBoxImage = top$("<img/>").appendTo($innerTableFirstRowFirstCell);
    $messageBoxImage.attr("alt", "");
    $messageBoxImage.attr("src", ""); //TODO: set src.

    var $innerTableFirstRowSecondCell = top$("<td/>").appendTo($innerTableFirstRow);
    $innerTableFirstRowSecondCell.addClass("messageBoxMessage");

    var $messageBoxMessage = top$("<div/>").appendTo($innerTableFirstRowSecondCell);
    $messageBoxMessage.attr("id", "MessageBoxMessage");

    var $innerTableSecondRow = top$("<tr/>").appendTo($innerTable);

    var $innerTableSecondRowFirstCell = top$("<td/>").appendTo($innerTableSecondRow);
    $innerTableSecondRowFirstCell.attr("colspan", "2");
    $innerTableSecondRowFirstCell.addClass("messageBoxDescription");

    var $messageBoxDescription = top$("<div/>").appendTo($innerTableSecondRowFirstCell);
    $messageBoxDescription.attr("id", "MessageBoxDescription");

    var $innerTableThirdRow = top$("<tr/>").appendTo($innerTable);

    var $innerTableThirdRowFirstCell = top$("<td/>").appendTo($innerTableThirdRow);
    $innerTableThirdRowFirstCell.attr("colspan", "2");
    $innerTableThirdRowFirstCell.addClass("messageBoxReasons");

    var $messageBoxReasons = top$("<div/>").appendTo($innerTableThirdRowFirstCell);
    $messageBoxReasons.attr("id", "MessageBoxReasons");

    return $messageBoxContainer;
};

Notarán que en la sección en la que se muestra el error fatal no se utiliza jQuery. En estas situaciones tenemos que evitar cualquier referencia externa al código que se está ejecutando, ya que sólo sabemos que ha ocurrido un error inesperado y no conocemos el estado de los demás componentes de la aplicación (como por ejemplo el plugin de jQuery. El error podría deberse a que el cliente no pudo descargar el script de jQuery). Aquí tenemos que esforzarnos en codificar, siempre dentro de lo posible, código que funcione en circunstancias extremas… y la mejor manera es que sea extremadamente simple.

Hasta aquí hemos abarcado las situaciones más comunes, y sólo en el marco de llamadas $.ajax al servidor:

  • Excepciones de negocio generadas del lado del servidor.
  • Errores producidos en del lado del servidor.

Parece una estructura demasiado compleja para, finalmente, hacer un “if” y determinar si rompemos la pantalla o mostramos un cuadro de diálogo, cubriendo apenas los dos puntos de arriba. Es un buen momento para repasar sus ventajas:

  • El código y la metodología en javascript es asimilable a lo que estamos acostumbrados a hacer en c#. Esto hace que la implementación sea natural,  fácilmente “explicable” y “recordable”. Verán que el resto de los puntos aquí presentados se aplican tanto a nuestra solución de javascript como al manejo de excepciones en c#.
  • Modularidad/Desacoplamiento: su único punto de anclaje con respecto al código correspondiente a la funcionalidad de negocio del sistema son los bloques try…catch en las funciones de manejo de eventos.
  • Reutilización: cualquier excepción que requiera el mismo tratamiento que las ya implementadas puede representarse con alguna de las clases ya existentes.
  • Extensibilidad: si queremos que el sistema reaccione a un nuevo tipo de excepción sólo tendremos que codificar “en las puntas”: allí donde se lanza la excepción (el lugar del throw) y allí donde se maneja (ShowException).

Por otro lado hay mucho para explorar de aquí en más. Recordemos que ni siquiera cubrimos los casos mínimos para una aplicación “aceptable”. Veremos que al contemplar más situaciones (errores y excepciones de lado del cliente, en la comunicación, etc.) y al integrar más funcionalidad (por ejemplo mostrando un mensaje de error especial en ambientes de desarrollo o testing), en el manejo de “pequeños detalles” y casos especiales, será cuando este esquema muestre sus verdaderas ventajas.

lunes, 22 de febrero de 2010

.Net MVC + jQuery: manejo de excepciones. III: Atrapar errores del lado del servidor y comunicarlos controladamente al cliente.

[Continuación de .Net MVC + jQuery: manejo de excepciones. II: El problema.]


works-on-my-machine Espero que se haya entendido el planteo desarrollado en los posts anteriores de esta serie (preguntar es gratis, de cualquier manera)… lo que sin duda ha quedado claro es que el problema es retorcido.

Lo que sigue ahora es mi resolución del tema, más que perfectible por cierto (si alguien tiene sugerencias…), pero lo suficientemente funcional y probada como para ostentar orgullosamente el sello que he aplicado a esta entrada.


El primer paso es poder diferenciar, del lado del cliente, si el error o excepción se produjo durante la ejecución del código que procesa una respuesta o si la comunicación en sí fue fallida.

La importancia de lo anterior radica en que en el primer caso manejaremos la excepción del lado del servidor y podemos devolver al cliente información detallada y en un formato conveniente sobre cómo proceder:

  • si es un error de sistema o una excepción de negocio o un error de validación, si mostrar información detallada o no, si bloquear la aplicación y obligar al usuario a reiniciar (o a joderse), etc.
  • si es un error en la comunicación el cliente deberá tomar sus propias decisiones, de acuerdo con la información que posea en ese momento, pero ya contamos con un dato fundamental: la operación no llegó al servidor, por lo que podemos estar seguros de que nada ha sucedido “del otro lado”.

Recordemos que de forma predeterminada el servidor devolverá un error 500 y el código HTML de la pantalla de error asignada a ese código (por defecto aquella tan bonita de .Net con las letras en rojo catástrofe y el cuadro amarillo con detalles, más las inútiles indicaciones que todos conocemos). Esto no es precisamente un formato fácil de interpretar desde el código a la hora de tomar decisiones en el front-end.

Necesitamos interpretar desde el código la excepción porque tenemos que tener en cuenta que muchos tipos de errores “de aplicación” diferentes. Cada situación puede requerir diferentes propiedades en el objeto Exception para transmitir la información relevante del caso. Consideremos por ejemplo:

public class ShowCaseException : ApplicationException
{
   private List<string> reasons = new List<string>();

   public ShowCaseException()
      : base() { }

   public ShowCaseException(string message)
      : base(message) { }

   public ShowCaseException(string message, Exception innerException)
      : base(message, innerException) { }

   public List<string> Reasons
   {
      get { return reasons; }
   }
}

La excepción anterior contiene una propiedad extra (“Reasons”) con una lista de mensajes para presentar al usuario. Esto es algo que suelo utilizar bastante, ya que si durante una operación se producen varios problemas de validación es bueno presentárselos al usuario todos juntos y no solamente el primero y obligarlo a resolverlo antes de probar de vuelta y encontrarse con otro y así, multiplicando la cantidad de intentos.

Pero no podemos tratar con cada tipo de excepción en particular, viendo en cada caso qué información devolver y cómo. Una solución más práctica es devolver la excepción serializada en formato JSON, más un flag en el header de la respuesta que la diferencie de las respuestas “normales”:

internal static class ExceptionHandlingHelper
{
 public enum ResponseStatusEnum
 {
  Normal,
  ApplicationException,
  UnexpectedException
 } 

 internal static void ApplicationInstance_Error(object sender, EventArgs e)
 {
  Exception exception = HttpContext.Current.Server.GetLastError();
  if (exception is ApplicationException)
   ResponseHeadersHelper.CurrentHeaders.Add("RESPONSE_STATUS", ResponseStatusEnum.ApplicationException.ToString());
  else
  {
   Log.WriteException(exception);
   ResponseHeadersHelper.CurrentHeaders.Add("RESPONSE_STATUS", ResponseStatusEnum.UnexpectedException.ToString());
   if (![DEBUG_MODE])
    HttpContext.Current.Session.Abandon();
  }

  HttpContext.Current.Response.Clear();
  HttpContext.Current.Response.Write(ExceptionHandlingHelper.SerializeException(exception));
  HttpContext.Current.Server.ClearError();
 }
 //.... etc ....
}

Tenemos entonces tres estados posibles para una respuesta:

  • Error de negocio: ResponseStatusEnum.ApplicationException, son las excepciones lanzadas mediante un throw en nuestro código, y que deben derivar, por convención, de ApplicationException.
  • Error inesperado: ResponseStatusEnum.UnexpectedException, son todas las demás, originadas en throws por validaciones de consistencia en nuestro código o directamente desde el framework.
  • Normal: todo bien.

Así que lo primero que hacemos en nuestra rutina de manejo de excepciones es conseguir la excepción y determinar de qué tipo es, agregando un header en la respuesta (“RESPONSE_STATUS”) para que el cliente javascript pueda diferenciarlas fácilmente de las respuestas normales. Si es un error inesperado podemos, adicionalmente, registrarlo en el log y limpiar la sesión del usuario.

Luego se modifica la respuesta que por defecto enviaría el servidor, utilizando Response.Clear(), Server.ClearError() y escribiendo en el objeto Response la excepción serializada en JSON.

La serialización de la excepción es un poco molesta dado que el uso común de JavascriptSerializer arroja una excepción por culpa de la propiedad TargetSite, que se vuelve recursiva en cuanto al tipo. Pero, por otro lado, habíamos establecido que en un ambiente de producción no es conveniente enviar toda la información de la excepción ya que puede exponer datos internos a un ocasional atacante. Así que tenemos que implementar nuestra propia serialización para esta clase.

Una forma sencilla es recorrer el primer nivel de propiedades del objeto Exception y dejar que JavascriptSerializer se encargue del resto. El siguiente ejemplo es una prueba de concepto –no pretende ser una guía de lo que es o no seguro enviar al cliente-, solamente omite en la serialización las propiedades “InnerException”, “StackTrace” y “Source”. Tal vez habría que agregar más restricciones, probando siempre qué información estamos enviando en cada caso.

private static string SerializeException(Exception ex)
        {
            JavaScriptSerializer serializer = new JavaScriptSerializer();

            StringBuilder exSerialized = new StringBuilder("{");
            PropertyInfo[] exProperties = ex.GetType().GetProperties(BindingFlags.Public | BindingFlags.FlattenHierarchy | BindingFlags.Instance);
            foreach (PropertyInfo property in exProperties.Where(p => p.Name != "TargetSite"))
            {
                if (![DEBUG_MODE] &&                    
   (property.Name == "InnerException" || property.Name == "Source" || property.Name == "StackTrace"))
                    continue;

                exSerialized.AppendFormat("\"{0}\":", property.Name);
                serializer.Serialize(property.GetValue(ex, null), exSerialized);
                exSerialized.Append(", ");
            }

            if ([DEBUG_MODE]) 
            {
                exSerialized.AppendFormat("\"ToString\":");
                serializer.Serialize(ex.ToString(), exSerialized);
                exSerialized.Append(", ");
            }

            exSerialized.Remove(exSerialized.Length - 2, 2);
            exSerialized.Append("}");
            return exSerialized.ToString();
        }

La información así serializada es fácil de acceder desde el cliente ya que se convierte automáticamente en un objeto similar a Exception, pero en javascript.

Notarán que en el ejemplo incluí, para entornos de desarrollo, una propiedad extra que contiene la cadena devuelta por el método ToString de Exception, que es lo que se suele mostrar por pantalla en caso de errores. Tendremos, en resumen, disponibles en javascript casi todas las propiedades del objeto Exception más una propiedad “ToString” que contiene una cadena con toda esa información en un formato legible para el usuario/desarrollador.

Volvamos a javascript para ver cómo manejamos la respuesta ahora. Partimos del ejemplo del post anterior completando algunos de los “placeholders” que habíamos dejado, ya que ahora sabemos exactamente cómo llega la información desde el servidor:

function Save( data, callback )
{
 var async;
 if( typeof callback == "undefined")
  async=false;
 else
  async=true;
 
 var returnValue = null;
 
 $.ajax({
  url: "Comments/Save",
  data: data,
  async: async,
  success: function (response, status, xhr) {

   //Exception handling.
   var responseStatus = xhr.getResponseHeader("RESPONSE_STATUS");
   var ex = null;
   if (responseStatus == "ApplicationException") 
   {
      var netEx = JSON.parse(response);
      ex = new ProgramException(netEx.Message, netEx);
      ex.Reasons = netEx.Reasons;
   }
   else if (responseStatus == "UnexpectedException") 
   {
      var netEx = JSON.parse(response);
      ex = new FatalException(netEx.Message, netEx);
   }

   if(ex!=null)
   {
      if (async)
         ShowException(ex)
      else
         throw ex;     
   }

   //Normal response handling.
   if (async)
    callback(response)    
   else
    returnValue = response;
  }
  error: function(XMLHttpRequest, textStatus, errorThrown) {
   var ex = [GET_EXCEPTION_INFO];
   if(async)
    ShowException(ex)
   else
    throw ex;
  }
 });

 //async => returnValue == null;
 //sync  => returnValue == response;
 return returnValue;
}

La parte modificada es la de la sección “success” -previa al “Normal response handling”-. Verán que ahora, para determinar si hubo una excepción se consulta el encabezado de la respuesta que incluimos en el manejo de excepciones del lado del servidor -xhr.getResponseHeader("RESPONSE_STATUS")-. No importa qué excepción de negocio se haya producido, este header aparecerá siempre que ésta derive de ApplicationException. En la serialización JSON se devolverán todas las propiedades del tipo específico –en un entorno de desarrollo, recordémoslo siempre- ya que utilizamos JsonSerializer.

Por ejemplo, si la excepción lanzada es aquella ShowCaseException de la que hablamos al principio, sabremos por el header que deriva de ApplicationException y al mismo tiempo conservaremos la propiedad “Reasons”, específica del tipo, al serializar. Si prueban verán que aparece en el objeto netEx cuando se ejecuta var netEx = JSON.parse(response);

Cuando deserializamos la excepción la encapsulamos en un objeto conocido para el cliente. Esto es para reflejar el hecho de que para el cliente de javascript sólo existen dos objetos derivados de Exception relevantes: los de negocio (excepciones “de programa” y los de sistema (“fatales”). Para ello creamos sus clases correspondientes, inspiradas un poco en las de .Net (una excepción base y dos derivadas), pero en estilo javascript. Esto no es necesario, pero me resultó muy cómodo (veremos luego):

//Exception base
ExceptionBase = function (type, message) {
    this.Type = type;
    this.Message = message;
};

//Program Exception
ProgramException = function (message, netException) {

    this.Reasons = [];
    this.NetException = netException;

    if (typeof message != "undefined" && message != null)
        this.Message = message;

};
ProgramException.prototype = new ExceptionBase("ProgramException", "Operation Error");

//Fatal Exception
FatalException = function (message, netException) {

    this.NetException = netException;

    if (typeof message != "undefined" && message != null)
        this.Message = message;

}

FatalException.prototype = new ExceptionBase("FatalException", "Unexpected Error");

Son estas dos clases las que nos permiten codificar luego este tipo de instrucciones:

var netEx = JSON.parse(response);
ex = new ProgramException(netEx.Message, netEx);
ex.Reasons = netEx.Reasons;

Hasta aquí, un paso más en la batalla. Nos resta:

  • Determinar cómo tratar los errores en la comunicación.
  • Determinar cómo mostrar toda esta información (hasta ahora no hicimos nada con el método “ShowException”).

Hasta la próxima, nos leemos. (Actualización: sigue en .Net MVC + jQuery: manejo de excepciones. IV: el lado del cliente.)

miércoles, 17 de febrero de 2010

.Net MVC + jQuery: manejo de excepciones. II: El problema.

[Continuación de .Net MVC + jQuery: manejo de excepciones. I: Requerimientos.]


Tengamos presente nuestro ejemplo de manejo de errores y excepciones en $javascript (jQuery):

$("#Save").click(function () {
 try {
  $("#CommentForm").valid();
  Save({
   User: $("#User").val(),
   Date: $("#Date").val(),
   CommentText: $("#CommentText").val()
  });
 }
 catch (ex) {
  ShowException(ex);
 }
});

Por el lado de las excepciones, tenemos en principio aquellas generadas por nuestro código. En el ejemplo, serían aquellas que arroje la función valid() luego de verificar los datos ingresados por el usuario.

Luego tenemos aquellas que se generen durante la llamada al servidor. Asumiendo que Save() hace una llamada $.ajax para enviar los datos al servidor, tenemos en realidad dos escenarios posibles: sincrónico y asincrónico.

Si la llamada al servidor es sincrónica Save() debe hacer un throw en algún punto del código con la información necesaria para que sea atrapado por el catch del código de arriba y ShowException muestre un mensaje al usuario.

Si la llamada es asincrónica deberíamos pasarle a Save() un parámetro callback, una función a ser invocada cuando el servidor responda. Por ejemplo (muy esquemáticamente):

Save({
 User: $("#User").val(),
 Date: $("#Date").val(),
 CommentText: $("#CommentText").val(),
 function(response){
  alert(response);
 }
});

En este segundo caso es el método Save() el que debe internamente contemplar la posibilidad de excepciones y decidir, de acuerdo con la respuesta, si invoca al callback o a ShowException.

Creo que en algunas situaciones es necesario el uso de llamadas asincrónicas, pero que en general es más fácil manejar la lógica sincrónica, por algo es por lo que se empieza al aprender a programar. Así que personalmente prefiero que cada función javascript que se comunica con el servidor dé la opción de pasar o no una función de callback.

Si juntamos estas dos opciones y hacemos un boceto de Save() quedaría algo por el estilo de:

function Save( data, callback )
{
 var async;
 if( typeof callback == "undefined")
  async=false;
 else
  async=true;
 
 var returnValue = null;
 
 $.ajax({
  url: "Comments/Save",
  data: data,
  async: async,
  success: function (response, status, xhr) {

   //Exception handling.
   if( [RESPONSE_IS_EXCEPTION] )
   {
    var ex = [GET_EXCEPTION_INFO];
    if (async)
     ShowException(ex)
    else
     throw ex;     
   }

   //Normal response handling.
   if (async)
    callback(response)    
   else
    returnValue = response;
  }
  error: function(XMLHttpRequest, textStatus, errorThrown) {
   var ex = [GET_EXCEPTION_INFO];
   if(async)
    ShowException(ex)
   else
    throw ex;
  }
 });

 //async => returnValue == null;
 //sync  => returnValue == response;
 return returnValue;
}

En el ejemplo se asume que si se pasa un parámetro de callback la llamada debe ser asincrónica. En este caso se ejecuta $.ajax, el flujo sigue en la línea siguiente y returnValue será null cuando Save() termine. En algún momento posterior, cuando el servidor responda, jQuery invocará al código que se pasa en el parámetro success de $.ajax. De ser una llamada sincrónica se ejecutará $.ajax e inmediatamente el código del parámetro success.

Si se produce un error o una excepción no controlada del lado del servidor $.ajax invocará a la función especificada en el parámetro “error”. Lo mismo sucederá ante errores en la comunicación en sí.

Tanto en error como en success debemos determinar, de alguna manera (que también veremos luego, en el ejemplo estos agujeros blancos están entre corchetes), si hubo una excepción o error. Si la hubo armamos un objeto “ex” con la información que necesite ShowException. Si no, devolvemos el valor.

La diferencia entre sincrónico y asincrónico en este punto es que en el caso de ser una llamada sincrónica hacemos un throw (que atrapará el catch de Save) o llamamos a la función callback o devolvemos el valor a través del retorno de la función, mientras que en el caso de la llamada asincrónica debemos manejar aquí mismo la excepción o llamamos a la función callback. Si hiciéramos un throw en este punto, durante una llamada asincrónica, la excepción sería atrapada por el navegador y el usuario vería un error de javascript (en el mejor de los casos. En el peor, no vería nada y pensaría que sus datos fueron grabados correctamente).

Hasta aquí las excepciones. Vamos ahora a contemplar la posibilidad de errores. Si no tienen en claro la diferencia les recomiendo –otra vez- hacer un paréntesis y leer este post.

A modo de resumen de ese post, recordemos que si al momento de grabar los datos “La fecha del comentario ingresado corresponde a un informe ya aprobado”, eso es una excepción (una situación contemplada en el código en forma de validación, un throw en nuestro código del lado del servidor. Es un mensaje que tiene utilidad para el usuario, que debe indicar que él ha cometido un error y no el sistema). Pero si al momento de grabar el sistema intenta insertar un valor nulo en donde no se puede, eso es un error (una excepción para el framework o la base de datos, pero una situación no contemplada en nuestro código).

¿Dónde deberíamos esperar errores? Fácil, en todos lados. Lo inesperado puede por definición aparecer en cualquier momento. Pensemos qué situaciones pueden darse y qué hacer en cada caso:

  • Un error en el código de negocio del lado del servidor: en este caso podríamos enviar una respuesta que le indique al código javascript (en success) que se ha producido un error de sistema y a ShowExceptions que debería “romper” la pantalla impidiendo que el usuario continúe utilizando la aplicación o mostrar información detallada, dependiendo de si estamos en un ambiente de desarrollo o testing.

    Un ejemplo sería el intento de utilizar una variable que está en nulo, pero también que la base de datos no esté disponible o muy ocupada, o un timeout de base de datos. Para este caso tendríamos una excepción del lado del servidor, pero que no deriva de ApplicationException.

  • Un error en la infraestructura del lado del servidor: en este caso el problema no está en nuestro código y no es atrapado por él. Es el que se daría si el servidor web está muy ocupado. Puede ser antes o después de la operación, pero en todo caso no es controlado por nosotros.

    Aquí no tendríamos una excepción de .Net del lado del servidor, sino que éste, sin que podamos evitarlo, devolvería un error HTTP (típicamente un error 500, aunque podría ser otro). En este caso es jQuery el que atraparía el error e invocaría a la función especificada en el parámetro “error” de la llamada $.ajax.

  • Un error en la llamada, del lado del cliente: en este caso la llamada $.ajax jamás llega al servidor (por ejemplo si la url es incorrecta o está mal formada).

    Aquí hay un punto de debate: dado que el error se produce enteramente del lado del cliente no tenemos posibilidad de registrarlo, sólo nos enteraremos de él a través de una comunicación del usuario (por mail, teléfono, o como sea). La única información de la que dispondremos será aquella que le mostremos por pantalla… pero no es una buena práctica mostrar detalles internos al usuario final… Pero esto es último es discutible, ya que si vamos a suponer un error provocado por un usuario malicioso es de todas maneras información a la que él puede acceder, ya sea que se la hagamos más fácil o más difícil.

    Lo que es seguro, volviendo al tema, es que ShowExceptions tiene que manejar también esta situación y, por lo menos, asimilarla a la indicada en los puntos anteriores y darle el mismo tratamiento.

  • Un error en el código javascript, del lado del cliente. Es decir, un error de javascript ya sea en la función Save() o en el manejador del evento click. Este tipo de errores sería atrapado por el catch más externo de todos, el de la función que asociamos al evento click.

    En este caso el objeto “ex” que ShowExceptions recibirá como parámetro no estaría armado por nosotros sino por el motor de javascript (y lo que es peor, será ligeramente diferente entre navegadores, e incluso entre distintas versiones del mismo navegador). Así que tenemos que contemplar también la posibilidad de que a ShowExceptions le llegue este otro objeto “más o menos desconocido” proporcionado por el motor de javascript.

  • Un error en el código de manejo de errores. Es decir, un error de javascript adentro de ShowExceptions. Créanme que el andamiaje necesario para todo este control es lo suficientemente complejo como para que tenga sus propios errores, y éste es el peor escenario: el error en ShowExceptions nos estaría ocultando aquél que le dio origen, y deberemos resolverlo antes de enfrentarlo. Dado que ShowExceptions es la última fortaleza del funcionamiento del sistema deberá ser a prueba de balas: ya no importa cómo ni en qué situación, su misión es mostrarnos todos los errores que se hayan producido (propios y ajenos) sin perder información y asegurarse de que la pantalla del lado del cliente quede bloqueada. Tarea ingrata si las hay, pero alguien tiene que hacerlo.

Resumamos, como para ir terminando este post ya demasiado extenso, las situaciones que debemos contemplar:

  • Excepciones generadas desde nuestro código en javascript (las que se generen en la función valid() de validación de datos ingresados por el usuario).
  • Llamadas sincrónicas y asincrónicas. La diferencia está en hacer un throw o llamar a ShowExceptions en la función que se comunica con el servidor.
  • Errores o excepciones generados del lado del servidor. En este caso la comunicación ha sido exitosa.
  • Errores en la comunicación en sí, provocados por la conexión (“se cayó la red”) o por el código (“url mal formada).
  • Errores en el código javascript que implementa una funcionalidad específica.
  • Errores en el código javascript de control de errores.

La vida no es fácil… luego seguimos. (Actualización: sigue en .Net MVC + jQuery: manejo de excepciones. III: Atrapar errores del lado del servidor y comunicarlos controladamente al cliente.)

lunes, 15 de febrero de 2010

.Net MVC + jQuery: manejo de excepciones. I: Requerimientos.

Me pasé las últimas semanas trabajando sobre la beta de Visual Studio 2010 (acaba de salir el Visual Studio 2010 RC) armando un esquema de trabajo (un mini-framework) para proyectos MVC, en un intento de materializar la experiencia acumulada en otros proyectos en la forma de herramientas encapsuladas, probadas y listas para reutilizar.

Uno de los puntos que más trabajo me ha llevado es el manejo de excepciones. Un tema traicionero, simple a primera vista pero complicado y retorcido a medida que se avanza. Siempre lo tuve cubierto (es decir, sin graves problemas) con un poco de alambre, pegamento y parches aquí y allá, y quise aprovechar este nuevo comienzo en limpio para pensar un esquema más consistente y por lo tanto más sólido y fácil de mantener.

Comencemos, como corresponde, por los requerimientos. ¿Qué pretendo de a la infraestructura de un proyecto en cuanto a manejo de errores y excepciones (teoricé sobre la diferencia hace un tiempo, en Errores y excepciones)?

En principio, un uso estándar y transparente. Por ejemplo, en el botón “Save” de una vista, el programador debería codificar, en javascript (+jQuery, por supuesto):

$("#Save").click(function () {
 try {
  $("#CommentForm").valid();
  Save({
   User: $("#User").val(),
   Date: $("#Date").val(),
   CommentText: $("#CommentText").val()
  });
 }
 catch (ex) {
  ShowException(ex);
 }
});

En el ejemplo anterior, el bloque try…catch captura los errores de validación disparados por la instrucción $("#CommentForm").valid(); (es el plugin jQuery Validation) y la función ShowException los muestra en una forma amigable al usuario. Este no es el comportamiento “normal” de la función valid() de jQuery Validation, hay que codificarlo.

Pero no sólo eso. La función Save del ejemplo debe enviar los datos al servidor y el servidor debe pasarlos al modelo de negocio y esperar excepciones. Excepciones del tipo “La fecha del comentario ingresado corresponde a un informe ya aprobado” y cosas por el estilo, tan molestas para nosotros como necesarias para nuestros clientes. Es decir que se comunicará con una acción en un controlador, supongamos:

namespace ShowCase.Web.Controllers
{
    public class CommentsController : Controller
    {
  public bool SaveComment(CommentsModel model)
  {
   model.Save();
   return true;
  }
    }
}

Vemos que la acción devuelve siempre true. Esto es porque espera que los problemas se comuniquen a través de las excepciones. Un ejemplo esquemático para el método Save del modelo sería:

public class CommentsModel
{
 public void Save()
 {
  FinancialReport financialReport = FinancialReports.GetByDate(this.Date);
  if(financialReport.Status == ReportStatus.Approved)
   throw new ApplicationException("The comment's date points to an approved report.");
  
  FinancialReports.SaveComment(financialReport, this);
 }
}

El manejo de este tipo de excepciones generadas del lado del servidor debería ser, para el programador de la funcionalidad, idéntico al de las generadas del lado del cliente. Así que tenemos que llegar, de alguna manera, desde el throw en el método Save de CommentsModel, al catch en nuestra función de javascript.

Para complicar las cosas, agreguemos los errores. Estamos hablando ahora de verdaderos errores del sistema: errores de codificación, de conexión con la base de datos, de conexión entre el cliente y el servidor web, de javascript, etc. Errores del tipo que solemos llamar catastróficos, pero que yo prefiero denominar inesperados, como para restarle dramatismo al asunto (un cliente que no llamaría a las 3 de la mañana por un error “inesperado” tal vez sí lo haga por uno “catastrófico”).

Es el tipo de errores, en definitiva, que deberían “romper” o “cerrar” la aplicación, puesto que se ha arribado a un estado no contemplado, y cualquier acción posterior podría derivar en datos corruptos, inconsistentes, o –por lo menos, y más probablemente- en nuevos, más molestos y más extraños errores.

La función ShowException del ejemplo debería diferenciar entre las excepciones de negocio y los errores. Para los primeros mostrará un mensaje al usuario, y para los segundos deberíamos grabar un archivo de log, y podríamos establecer dos comportamientos posteriores:

  • uno para desarrollo o pruebas, mostrar por pantalla toda la información disponible acerca del error, y dejar que la aplicación siga abierta (el desarrollador o tester decidirá por sí mismo si puede continuar o no sin problemas),
  • y otro para producción, limpiar completamente la pantalla y mostrar un mensaje de error escueto invitando al usuario a reiniciar la aplicación o a llamar al administrador del sistema (siempre y cuando no seamos nosotros).

Es importante que, en entornos de producción, no sólo la función ShowException no muestre más de lo que debe, sino que el servidor mismo no envíe más información que la estrictamente requerida.

Todos estos requerimientos deben implementarse, dentro de lo posible, en una forma transparente al programador de la funcionalidad. Personalmente considero esta transparencia como algo muy importante, y la resigno (obligando al programador a derivar de ciertas clases, a implementar o a invocar ciertas funciones especiales) sólo cuando la alternativa es imposible o extremadamente más complicada. Cuando programamos una funcionalidad tenemos la cabeza puesta en facturas, aprobaciones, balances, fechas de cierre… en ese contexto, dónde fue generada la excepción o qué tipos de excepción hay y cómo deben transmitirse desde su origen hacia el cliente, son sutilezas que de requerir tratamiento especial serán seguramente pasadas por alto.

Pero, en definitiva, qué tan importante es esta transparencia o cuándo una alternativa es “imposible” o “extremadamente complicada” dependerá de cada uno. El hecho es que gracias a .Net MVC y jQuery podemos lograr un nivel muy aceptable de transparencia a través de diferentes puntos de intercepción y extensión convenientemente ubicados en la infraestructura del proyecto.

Suficiente para una primera entrega. En la próxima –en breve- analizaremos más en detalle los requerimientos en busca de las situaciones más comunes y los problemas que deberemos enfrentar al momento de picar el código.

Continúa en .Net MVC + jQuery: manejo de excepciones. II: El problema.

jueves, 10 de septiembre de 2009

Estar en la pomada.

No tiene nada que ver con lo que iba a escribir, simplemente me dio curiosidad el origen de la expresión, y aquí va:

Cuenta la leyenda que hace siglos, en Bretaña los soldados partían a la batalla numerados. Cada guerrero exhibía un pendón con un determinado número de manzanas […]

Llegados tiempos de escasez, entre otras muchas cosas empezó a faltar el ungüento con que se curaban las heridas de los guerreros a su vuelta del combate, de modo que se decidió usar la clasificación de la pomada para ver quién tenía derecho a que sus heridas fueran curadas con el escaso ungüento […]

De este modo, se generalizó primero la expresión estar en el ungüento, que, posteriormente, cuando el grupo de pendonados con manzana pasó a ser conocido como la pomada, quedó como estar en la pomada, como sinónimo de estar en el grupo de los primeros clasificados.

(extracto del blog infulas)

Aclarado el punto (mucho más interesante que lo que sigue, por cierto) voy a la pequeña reflexión que lo motivó: desdesarrollo está en su máximo de visitas, pegando un interesante salto respecto del mes anterior.

Tan interesante ha sido el susodicho que me he puesto a revolver el analytics con un poco más de obsesividad que de costumbre en busca de su origen.

Quería corroborar que, encantados con mi prosa, inteligencia y capacidad analítica (e ironía), los lectores caían en masa.

Finalmente no me ha quedado otra que enfrentar la verdad: la causa ha sido la aparición de ciertas palabras en los títulos, palabras que han atraído especialmente la atención de google. La marea no es de lectores sino de buscadores, y de ellos una ínfima parte pasa más de 5 segundos en el blog.

Somos, en definitiva, más o menos los mismos de siempre. La única diferencia es que en vez de estar charlando en una esquina de pueblo lo estamos haciendo en medio de una concurrida estación de trenes.

¿Qué es lo que ha transformado aquella esquina solitaria en este concurrido lugar de paso? Las palabras han sido, no muy soprendentemente: “jQuery” y “AJAX” (de la serie Ajax: C# .Net 3.5 + jQuery).

Qué mejor indicador de cuáles son las tecnologías que hay que dominar para estár “en la pomada” hoy en día que el  constante crecimiento de las búsquedas que se realizan alrededor de jQuery:

Cada vez me convenzo más de que el futuro de la web (y de la mayoría de las interfaces de usuario) será escrito en javascript.

domingo, 6 de septiembre de 2009

El estilo, la legibilidad, los “malos” programadores y el ¿diabólico? codebehind en el Microsoft .Net MVC.

Antes que nada: si usted, querido lector-programador de .Net, no tiene y/o no quiere tener nada que ver con el .Net MVC de Microsoft siga leyendo de todas maneras, que la cuestión va mucho más allá de eso y es interesante.

Los hechos.

El hecho es que en el .Net MVC de Microsoft, las vistas no tienen codebehind. En realidad no es que no tengan o no puedan tener, sino que por defecto no lo tienen, siendo el estilo de codificación sugerido para las vistas más o menos como lo muestra esta imagen:

MVCview

Es decir, utilizamos los viejos y conocidos tags <% %> para escribir código C# inline en medio del aspx, el javascript y el html. Los controles del lado del servidor (TextBox, CheckBox, DropDown) han sido reemplazados por un helper que utilizamos para no escribir un montón al implementar tareas comunes (como ponerle un valor a un input type=text) pero que es sólo eso, un helper.

Las opiniones

La verdad que es un cambio importante en la forma de pensar y escribir una página web en .Net. Personalmente a mí me ha costado muchísimo adaptarme (y, les adelanto, me he dado por vencido y vuelto al codebehind). Indagando un poco sobre este tema me encontré con que, obviamente, no soy el único.

Pero vamos a las opiniones, y primero las que están en contra (del codebehind): Steven Smith, comentando la reaparición del codebehind en las próximas versiones del framework, dice en su blog que, lisa y llanamente, Codebehind Files in ASP.NET MVC are Evil. Steven no es ningún improvisado, hay que pensar en sus razones (el resaltado es mío):

The problem with having a codebehind file for a View comes down to temptation and habit.  If it's there, anybody who's been using "classic ASP.NET" for the last 8 years or so is accustomed to putting all kinds of things into the ASP.NET codebehind files.  From click handlers to Page_Load to event wireups to changing display settings based on the value of a data item - most web forms apps have a ton of logic in their codebehind files.  And that's great - but not typically how it should be done with ASP.NET MVC.

[…] If having the codebehind file available by default is a temptation to stray from the canonical correct MVC path, then not having it there by default would help most developers do things the right way without thinking about it.

Encontré, en el mismo set de resultados en google, una respuesta de Luis Abreu posteada en su blog en una entrada titulada (obviamente) Codebehind files in ASP.NET MVC *ARE NOT* evil (el resaltado es mío).

Before going on, I understand Steve’s point of view: keeping the codebehind files might lead you to put code that belongs to the controller on the view. As I said, I understand, but I want to believe that a good developer will understand MVCs strenghts and will, after some time, have no doubts on where some behaviour (code) should go.

On the other hand, I’m not sure that removing the codebehind file will be enough for stopping a “bad” programmer […]

Luis tiene un sueño, que yo comparto:

Let me share with you a dream which makes me stick harder with the “pro-codebehind” approach […]

Imagine seeing no more of those <% %> floating everywhere on your aspx page…having a clear separation between markup and code, which doesn’t happen with the current view engine. If you want to really imagine it, just compare the old spaghetti ASP code with the elegance of the ASP.NET web forms page but don’t think about events and view state…just concentrate on the markup. Now be honest: do you preffer the spaghetti or the web form’s approach […] ?

Yo mismo no lo hubiese expresado mejor. Pero esa es mi opinión, es hora de comenzar otra sección.

Mi punto de vista 1: la estética.

Si hay algo que no me gusta en cuestiones de arquitectura (y de desarrollo de software en general) son las opiniones categóricas: “los tags <% %> son el demonio”, “el codebehind es el demonio”, “todo el sql debe estar en la base de datos”, “los parámetros opcionales son el demonio”, “los objetos no deberían tener propiedades”… un largo etcétera. Me parece que se confunden directivas de diseño con reglas inmutables escritas en piedra, tiendo a pensar que el que las pronuncia no está pensando en la situación actual y real del día de hoy sino evadiéndose hacia un mundo perfecto donde la arquitectura y las necesidades son la misma cosa.

Yo soy más del estilo de aquellos Principios de Diseño de Guido van Rossum que publiqué en uno de mis primeros posts. Voy a traer a colación los que me parecen relevantes:

  • Hermoso es mejor que feo.
  • La legibilidad cuenta.
  • Los casos especiales no son suficientemente especiales como para romper las reglas…
  • Aunque lo pragmático gana a la pureza.

No hay absolutos, hay momentos en los que hay opciones, herramientas entre las que hay que elegir, ventajas y desventajas. Con Rick Hunter (más que experimentado arquitecto) solíamos terminar este tipo de discusiones con la frase “no nos queda otra… hay que pensar”. No queríamos pensar, queríamos una regla mágica que nos solucionara la vida… si existe la verdad es que nunca la encontramos.

Volvamos al caso. Piensen en los cuatro puntos de Guido, recuerden –si es que han trabajado con él- ASP 3.0. Ahora vuelvan a mirar la imagen de arriba e imaginen esa sintaxis en la implementación de una página realmente compleja. Las interfaces de la vida real son complejas, los usuarios quieren interactividad, quieren ver lo que pasa cuando cambian valores, quieren cosas que llamen la atención sobre los errores lo antes posible, no son un formulario en el que el tipo introduce datos, aprieta un botón y se va a su casa.

Yo veo un infierno de colores en el que se mezclan C#, markup de .Net, html, javascript, y cuanta cosa se nos ocurra meter en una página web. Por cierto, Guido también dice:

  • Disperso es mejor que denso.

Yo creo que sería mejor tener todos esos lenguajes separados que revueltos e interactuando juntos en el mismo lugar.

Mi punto de vista 2: los “malos” programadores.

Steven Smith le teme a los inexpertos, a los viejos y a los malos programadores (todos les tenemos miedo). Respecto de los primeros, siente que nunca abandonarán .Net “tradicional”, y que si abre esa puerta van a implementar toda la funcionalidad en la vista, dejando los controladores vacíos. A los últimos quiere obligarlos a hacer las cosas bien.

Eso es imposible. Un mal programador hará las cosas mal (no “más fácil” o “más difícil”, sino simplemente mal) independientemente de dónde esté picando código. Y eso es inevitable. Si hubiese una forma de forzar a un programador a hacer bien las cosas, entonces su trabajo sería reemplazable por una herramienta automática, y por lo tanto inútil… en general no es ése el caso.

El “malo”, ya lo dije, es incorregible y sólo podemos alejarnos de él o a él de nosotros. Al resto, a los inexpertos o a los “viejos” que vienen de otras tecnologías basta con mostrarles que es mejor separar la lógica entre vista y controlador, seguirlos, corregirlos, darles las herramientas y los criterios para elegirlas.

No creo que el objetivo un framework sea el control o la restricción. Su objetivo es estructurar, proponer un orden, facilitar el desarrollo, no impedirlo. Un buen framework no es aquél en el que no se puede programar mal, sino aquel en el que que programar bien es más fácil.

Mi personalísima conclusión

Volviendo a MVC: yo voy a cambiar los <%=Html.Input(…)%> por controles, y a agregar el codebehind para establecer sus valores e implementar la lógica de presentación en forma separada del html. Porque es más prolijo, más lindo, tal vez disperso pero mejor que denso, tal vez más complejo, pero mejor que complicado.

¿Y a uds. qué les parece?

domingo, 30 de agosto de 2009

20 sitios web muy mal diseñados.

La gente de Manolith ha recopilado estos sitios en su entrada 20 of the Worst Designed Websites In the World.

Si bien hay algunos que -en mi opinión- no acumulan suficiente mérito como para ser incluidos en semejante “lista de la vergüenza”, el resultado final del recorrido es un fuerte mareo y dolor de cabeza.

Lo malo no es ser incapaz de crear un buen diseño –yo soy incapaz de ello- sino el mal gusto liso y llano –y la falta de un poco de sentido común- que impide al creador del sitio (la frase “diseñador del sitio” está fuera de lugar, queda claro que no todo el que diseña es diseñador) reconocer que algo no está del todo bien.

Un par de ejemplos:

014

094

143

A ver si alguno de los incluidos en esta lista se decide a pedir ayuda profesional, o por lo menos a robar inspirarse en algún sitio un poco más sobrio y bien diseñado.

Encontrarán la lista completa y los links a los sitios (si es que se quedaron con ganas) en el artículo original.

Visto en Menéame.

miércoles, 19 de agosto de 2009

10 Principios para el diseño de la interfaz del usuario.

drowsy_2_080228_ms

“A modern paradox is that it’s simpler to create complex interfaces because it’s so complex to simplify them.”

– Pär Almqvist

  1. Conoce a tus usuarios.
  2. Presta atención a los patrones.
  3. Mantente consistente.
  4. Jerarquiza visualmente.
  5. Da feedback en cada acción.
  6. Soporta los errores del usuario.
  7. Da el control al usuario.
  8. Habla su lenguaje.
  9. Mantenlo simple.
  10. Avanza, actualiza, no te estanques.

Desarrollados en el artículo original (en inglés): 10 User Interface Design Fundamentals (vía @DeliciousHot).

martes, 23 de junio de 2009

Paradigmas.

Los desarrolladores somos –¿hipótesis?- ante todo humanos, luego usuarios, luego desarrolladores.

Como humanos –entre otras cosas-, tendemos a sobrevalorar la propia experiencia. Por ejemplo, si el sistema que desarrollamos nos es fácil de utilizar solemos atribuirle esta característica obviando el hecho de que hemos aprendido a utilizarlo “desde atrás” (es decir, desde el código, el diseño o los requerimientos) y no “desde adelante” (desde la pantalla, los manuales o la capacitación). Para cuando nos enfrentamos a la pantalla de inicio ya sabemos casi de memoria todo lo que sigue. Abstraerse de este conocimiento es –por más que me juren y recontrajuren- imposible, y es por eso que nuestras pruebas y experiencias personales son bastante objetables como medida de lo que sucederá en el mundo real. Esto se aplica, con variaciones, tanto a desarrolladores como a analistas, testers, líderes de proyecto y a cualquiera implicado en el desarrollo de software (excepto, claro está, al cliente y al usuario).

Además de humanos –si es que damos por válida la hipótesis-, somos usuarios de sistemas de un determinado negocio: entornos de desarrollo, clientes de bases de datos, herramientas de diseño y documentación de requisitos, entre muchos otros, conforman el software de soporte al negocio del desarrollo de software. Negocio en el que estamos inmersos y que, como todos, tiene su paradigma establecido y materializado en la forma de determinados estándares: flujos de trabajo, herramientas visuales, disposición física de los objetos en una oficina… todo lo que nos rodea se deriva de éste en alguna medida.

La importancia de estos elementos –paradigma y estándares- que sobre el papel parecen un conjunto arbitrario de caprichos funcionales -¿por qué Ctrl+U y Ctrl+Shift+U? ¿Por qué un árbol y no una serie de listas encadenadas?- radica en que condicionan toda nuestra visión de la realidad (¡vaya si estamos condicionados por los paradigmas de nuestro negocio!). Los sistemas -si pretenden ser exitosos- deberán respetar –o revolucionar, pero esto es más difícil-, sobre todo en la interacción con sus usuarios, los paradigmas del negocio para el que fueron diseñados.

Como desarrolladores que somos –de eso sí estamos seguros- nos sería imposible, si estuviésemos librados a nuestro criterio, no aplicar el paradigma y los estándares propios del negocio al que pertenecemos –el desarrollo de software- a los sistemas que desarrollamos.

El problema es que, como establecimos más arriba, otros negocios o actividades tienen estándares y paradigmas diferentes. Internalizarlos es prácticamente imposible (deberíamos ser, por ejemplo, tan usuarios de distintos sistemas de gestión como lo somos de distintos entornos de desarrollo, tanto como lo es un empleado administrativo que ha transitado por diferentes empresas y puestos). Sólo podemos pretender, a lo más, conocerlos. Y para ello se requiere de una experiencia… “presencial”. Es la experiencia que trata de transmitir el analista funcional, el área comercial o quienquiera que tenga contacto directo con el cliente.

Pero un modelo mental es algo realmente difícil de describir, los estándares que se deriven de éste serán en su gran mayoría reglas y prácticas comunes y no estarán explicitadas en ningún lado. Es, en definitiva, difícil de transmitir. Por todo esto, cuantos más intermediarios haya entre aquellos que conocen a los clientes y usuarios y los desarrolladores, más probabilidades habrá de que nos apartemos del paradigma y los estándares a los que ellos están acostumbrados.

miércoles, 15 de abril de 2009

Jugando con PhotoFace.

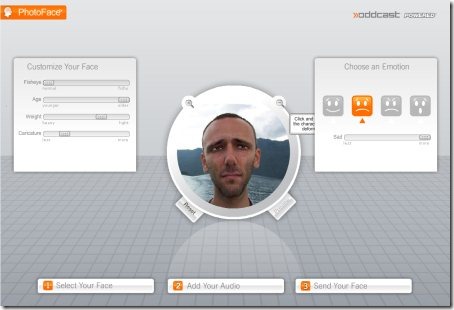
PhotoFace es una aplicación online que nos permite subir una foto y juguetear un poco con ella, con varios efectos que nos permiten llevarla desde lo…

normal

¿normal? Bueno, por lo menos para mí. Hasta…

honeyimhome

“Hi, honey, I’m home”, o…

deathproyect

“¿Qué hice yo para recibir este código?”.

También podemos agregarle audio para enviárselo a alguien junto con la imagen. Es… extrañamente adictivo. Vale la pena pegarle un vistazo.

Visto en Código Geek.

lunes, 30 de marzo de 2009

Renovación y primeras impresiones de Windows 7

Los asiduos habrán notado una brusca caída del ritmo de publicación en estas últimas dos semanas. El trabajo tuvo algo que ver (no mucho). El inicio de clases, con las corridas y preparativos de última hora pesó un poco más. Pero la razón principal ha sido el fallecimiento de mi computadora de escritorio (una Pentium 4 HT 3.2Ghz).

Es posible que haya muerto de envidia. Su deceso se produjo a las pocas semanas de la compra de una Acer Aspire One (apenas una netbook, pero ya la superaba en performance). A través de este post le rindo un sentido homenaje…

Pero la vida sigue. No soy de jugar con el hardware. Cada vez que una máquina dice “basta” hago el esfuerzo y compro el equipo más potente que puedo para olvidarme del tema por un par de años, durante los que no me preocupo en lo más mínimo por su mantenimiento hasta que casca nuevamente.

Es ésa y no otra la razón de mi elección por un Intel Core 2 Quad Q8200, sobre un motherboard Intel DG31PR con 4Gb de RAM y una placa de video “decente” (no soy un fanático de los juegos), una GeForce 9400 GT.

Lo anterior solamente viene a cuento de poner en contexto lo que realmente me interesa, que no es el hardware sino el software. Hace un tiempo que venía con ganas de probar la beta del Windows 7, así que aproveché la obligada migración para distribuir un poco más racionalmente mis datos (después de un par de años programas, documentos, fotos, videos y desarrollos e instalaciones a medias convirtieron mis discos en una masa compacta, indivisible y desordenada de archivos) e instalarlo en una partición propia.

Preconceptos

La verdad es que si bien la muy respetable opinión (y entusiasmo) de uno de mis compañeros de trabajo cultivó mi curiosidad, era escéptico respecto de la nueva interfaz.

He visto el Windows Vista de lejos pero en la oficina sigo con el XP (que es, en mi opinión -y creo que en la de la mayoría de los usuarios-, el mejor sistema operativo de Microsoft al momento). Esperaba entonces más o menos lo mismo de siempre: muchos cambios estéticos, algunos realmente molestos, la mayoría simplemente inútiles o intrascendentes, y las opciones y funcionalidades de siempre redistribuidas de modo que se maximiza la frustración en las primeras semanas de uso, hasta el momento en el que uno se rinde y somete a los designios de la nueva UI.

Las críticas al Vista, y mi percepción de que el 7 seguiría a grandes rasgos la misma línea no ayudaban mucho. Escéptico por naturaleza, descreía del buzz positivo alrededor de la nueva versión. En resumen, esperaba el chiste de siempre: uno se pasa la primera media hora jugando y los dos o tres primeros días tratando de dejar todo como estaba.

Instalación

Primero hacer un poco de espacio: achiqué la partición de un disco de 300Gb (nota mental: es bueno tener por lo menos dos particiones –datos y sistema operativo-) con el Partition Magic y creé una nueva de 20Gb. Un par de errores y reintentos después los datos contenidos en aquel disco estaban perdidos. Empezamos bien.

Ya molesto por el trabajo de recuperación que se avecinaba inicié con el disco de instalación del build 7057 de Windows 7.

Primera sorpresa: Ok, empezaba con una partición limpia, pero eso no resta méritos. Siguiente-siguiente-siguiente, escasos 20 minutos y ya está. No lloró por drivers, ni pidió actualizaciones, no aparecieron las típicas e inútiles preguntas que interrumpen la instalación cada 5 minutos (obligándome a aburrirme cerca de la máquina), ni siquiera se equivocó con la distribución de teclado.

Me pasé el resto del día recuperando y reorganizando los archivos perdidos en el movimiento de particiones, para finalmente reformatear todo el espacio libre. Trabajo aburrido si los hay, pero tengo que reconocer que la vida es más fácil teniendo las cosas ordenadas.

Primeras impresiones

Sorpresa. Es lindo. Bueno, eso era esperable. Pero más que lindo… es casi… sobrio. No molesta. No pregunta. No aparecen mensajes extraños ni anuncios catastróficos compitiendo por mi atención para que baje, actualice o descubra.

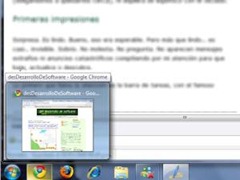
barraWindows7Lo primero que llama la atención es la barra de tareas, con el famoso preview que aparece al pasar el cursor por encima del ícono del programa abierto.

Pero es más que un “chiche”. Moviendo el cursor sobre el preview la ventana emerge al frente mientras las demás se vuelven transparentes, desde allí mismo podemos cerrarla o minimizarla, o volver a la ventana anterior con sólo desplazar el mouse fuera del preview. Se puede agregar o quitar el acceso directo a ese programa en la barra de tareas desde allí mismo, por lo que ya no hay que “personalizarla”, uno lo va haciendo y deshaciendo sobre la marcha.

searchBoxWindows7La otra característica que me impresionó desde el primer momento es el cuadro de búsqueda en lo que antes era el “menú de inicio”. Mantiene el foco siempre que esté abierto el menú y va mostrando los programas y opciones de configuración que concuerdan con lo que vamos tipiando. Creo que puede extenderse para buscar en internet desde allí mismo, pero todavía no lo he probado.

Ese primer día me la pasé explorando y tocando opciones… y dejé todo como estaba. No, no dejé todo igual al XP, dejé todo igual a la configuración por defecto.

La convivencia

Luego reinstalé el XP en otra partición (hay que conservarlo, no olvidar que esto es una beta), y obviamente eso rompió la instalación del 7. Reparé la instalación del 7 desde el CD (identificó el problema –XP instalado después del 7 o Vista embarulla la configuración del multiboot- y lo reparó puntualmente, sin reinstalar) y –obviamente- rompió el XP (bueno, algunas cosas no cambian nunca). Indagando un poco me enteré de que el viejo y sencillo boot.ini fue reemplazado por el retorcido y complicado BCDEdit, que superó en largo mi paciencia para estos temas, con lo cual decidí simplemente borrar todo, instalar primero el XP en una partición, luego el 7 en otra y a otra cosa mariposa (¿ven para qué es bueno tener datos y archivos propios por separado? Yo aprendí de la manera difícil). Pero más allá de esos primeros roces los dos sistemas operativos conviven y comparten el resto de las particiones sin problemas.

Un par de días después

Me rindo, tengo que reconocerlo: Windows 7 es muy, pero muy bueno. Me molesta trabajar con XP, simplemente me molesta. Las nuevas características (sobre todo las dos mencionadas arriba) son tan naturales que es tan fácil acostumbrarse a ellas como difícil resignarlas luego.

Es obvio que Microsoft ha escuchado mucho a sus usuarios y se ha adaptado más a ellos que en otras versiones, abandonando esa actitud de –me parece- imposición de visiones en la forma de interacción con el sistema.

El rendimiento es impecable, aunque es obvio que si no lo fuera en esta máquina ya sería el colmo. Me han comentado que se degrada elegantemente en equipos con menos recursos, pero no lo he probado personalmente.

Han cascado varios programas (por mérito propio), y por supuesto que programando y probando he metido un par de bucles infinitos, ejecutado algún que otro código malicioso, y llevado la máquina casi al límite (con un par de máquinas virtuales haciendo de servidores de base de datos y de páginas web al mismo tiempo) y el sistema operativo ha respondido siempre sin problemas. Dudo que alguna vez le exija más que eso y estoy seguro de que un usuario medio tampoco.

Conclusión

De que Microsoft le ha vuelto a robar ideas se ha vuelto a inspirar en Apple, a Ubuntu y demás no caben dudas. De que nos vuelven a usar como beta testers gratuitos han escuchado a los usuarios tampoco. También es verdad que para mí, por primera vez desde aquel traumático primer pasaje del NT 3.11 al 95 (¡¿dónde están mis grupos?! ¡¿Qué es esto del escritorio?!) la transición es suave, relajada, para nada traumática, y, en definitiva, muy positiva.

Windows 7, en beta y todo, ya es mi sistema operativo por defecto desde hace una semana completa, en la que me he dedicado más a trabajar que a jugar (aunque he vuelto a jugar bastante, ahora que puedo) y tengo que reconocer que es más que cómodo. Por primera vez Microsoft ha logrado que su interfaz llegue velozmente al objetivo: volverse invisible al usuario.

Ahora no hay excusas para volver al ritmo habitual. Nos leemos.

martes, 17 de febrero de 2009

La interfaz del usuario en un sistema de gestión.

Hablando puntualmente de sistemas de gestión tenemos en realidad varias interfaces de usuario:
  1. Orientada a la captura de datos.
  2. Orientada a la obtención de información.
  3. Orientada al análisis o búsqueda de información.

Recorramos cada una de ellas.

Orientada a la captura de datos: El usuario es un operario o empleado abocado a una tarea cuyo foco está fuera del sistema de gestión: atender a un cliente, a un proveedor, pagar una factura, recibir materiales. Otra posibilidad es que la carga de datos sea el objetivo en sí mismo (un data entry).

En el primer caso contamos con la mínima atención por parte del usuario, que tal vez ni siquiera mire la pantalla. En el segundo estará concentrado en el ingreso y verificación y su atención al resto de la pantalla será nula.

Lo esperable es una infinidad de pantallas prácticamente iguales, los clásicos ABM o CRUD. Aquí la regla número uno es simplemente no innovar. El usuario probablemente trabaje o haya trabajado con otros sistemas de gestión y espera algo muy específico: dato – [enter o tab] – dato – [enter o tab] – dato – [enter o tab] – fin. Cualquier cosa que se aparte de este camino le resultará molesta y probablemente inútil.

Este escenario sugiere el minimalismo, la simplicidad absoluta en el diseño de la interfaz. Esto coincide con las necesidades del desarrollo: es casi imprescindible generar estas pantallas a través de algún método en el que se ingresan los campos necesarios y la pantalla se genere automáticamente, asegurando la consistencia en el método de ingreso.

Orientada a la obtención de información: Nuevamente el objetivo central no es la información en sí. Será el control de la facturación, del inventario, de un envío o despacho de mercadería, etc. Son informes estándar, rutinarios y usualmente orientados al control de la operación.

Debería primar el minimalismo. Pocas opciones, pocos datos, y dispuestos de manera tal que facilite el control para el que fueron diseñados.

Aquí es donde fallan algunos sistemas. Estos reportes son usualmente puestos en la misma bolsa de los reportes de análisis, cuyo objetivo es otro (ya veremos). Es cuando el usuario se encuentra con un sinfín de posibilidades (vendidas como reportes “personalizables”, “configurables”, “autocustomizables” u otra palabra más o menos rara) en un momento poco oportuno. Si la tarea es rutinaria, ¿por qué el sistema me pregunta cada vez qué es lo que quiero?

Otras veces el reporte entorpece más de lo que ayuda, usualmente por algún detalle menor, que se vuelve terriblemente molesto.

Caso típico: el orden. Un ejemplo que me toca de cerca: cada vez que voy a buscar el recibo de sueldo me preguntan por el número de legajo que, obviamente, nunca recuerdo. Así que doy la única información de la que dispongo: mi nombre. Se imaginarán lo que sucede: hay que buscar secuencialmente entre todos los recibos, una y otra vez.

La “solución” a veces viene en forma de parche delirante: una segunda lista de empleados ordenada por nombre. Primero se busca allí el legajo, luego en la pila de recibos el correspondiente… un índice. Se le ha transferido al usuario parte del trabajo de la base de datos. Debería transferírsele también parte del sueldo del analista que diseñó el reporte.

La “customización” debería estar del lado del desarrollo, o de la parametrización, pero en todo caso del lado del proveedor de software. Al fin y al cabo éste debería ser producto de las horas de análisis funcional presupuestadas.

Muchas veces, amparado bajo el rótulo de “informes configurables”, el proveedor de software transfiere parte del análisis funcional al cliente -o lo que es peor, al usuario- al desligarse de la responsabilidad de decirle al sistema qué es lo que necesita. Esto no será un defecto siempre y cuando esa transferencia de costos se refleje en la factura del software.

Sin embargo, el problema de transferir esta decisión al usuario final es la posibilidad constante de error. Si para cada operación de control se solicitan más parámetros de los estrictamente requeridos para el reporte, un error en el ingreso de éstos es un error en el control.

Si se transfiere la responsabilidad al cliente –no al usuario, al cliente- y el personal -no necesariamente expertos en la administración del sistema- se equivoca en el armado de un reporte customizable podrían estar viciadas todas las operaciones de control derivadas.

Éstos son los “ABM” de los reportes. También deberían ser generados automáticamente durante el desarrollo. Es, en mi experiencia, la opción más simple.

Otra posibilidad, que dependiendo de las circunstancias podría llegar a ser más compleja o no, sería la creación de un módulo de reportes configurable. Pero… ¿no estaríamos recreando de alguna manera una herramienta de reporting, pero con menos posibilidades y orientada a un negocio específico? ¿no estamos reinventando la rueda? ¿no sería más simple utilizar una herramienta ya existente y entregar los reportes ya armados? No hay respuestas únicas. Pero éstas son preguntas que siempre deben estar presentes en la decisión.

Orientada al análisis o búsqueda de información: En este caso el usuario es un gerente, un ejecutivo de alto nivel, enfocado hacia el negocio, no hacia la operación. No sabe qué es lo que quiere, simplemente busca. ¿Qué busca? Muchas veces no lo sabe. Una variación, una anomalía, un producto que se desenvuelve mejor en un área que en otra (¿cuál? ¿en dónde? ¿por qué?).

Es, muchas veces, quien ha decidido, decidirá o puede decidir la compra, la adopción o la continuidad del software. Es El Cliente, con mayúscula.

Éste es el mundo de la “información estratégica”, y es aquí donde puede lucirse un sistema de gestión. Y puede hacerlo de dos maneras:

  1. Mostrando un conocimiento profundo del negocio, presentando reportes de análisis desconocidos para el usuario-cliente con información relevante.
  2. Presentando una interfaz que le permita navegar intuitivamente, buscar y encontrar aquélla información tan valiosa.

Para el equipo de desarrollo el primer camino es el de la experiencia, el segundo el de la pericia, la creatividad y la inversión en interfaces de usuario (los usuarios de Google Analytics sabrán a qué me refiero con pericia, la interfaz es bastante simple y permite hacer prácticamente cualquier cosa).

Las herramientas de data warehousing o almacenes de datos son una posibilidad, pero usualmente demasiado complejas para este tipo de usuarios. El desafío es adaptarlas de acuerdo al perfil concreto del cliente y del negocio en el que se desenvuelve. Delegar esta tarea en el cliente mismo, si bien es posible, implica arriesgar aquella funcionalidad en la que se podría marcar la diferencia.

En resumen: un sistema de gestión puede ser enorme, pero su desarrollo puede ser prácticamente automático. La energía debería concentrarse en las herramientas de generación automática (para las interfaces de ingreso de datos y reportes de control) ganando en bajo coste y velocidad en el desarrollo, y en la interfaz de análisis estratégico, donde puede diferenciarse de los demás productos o encontrar un nicho de negocio protegido.

sábado, 7 de febrero de 2009

“No a todos”

¡El tiempo que habré perdido por no saber decir "no a todos" al copiar archivos en Windows!

notoall

Por alguna razón que escapa a mi comprensión (y a la de muchos usuarios de Windows) ese botón (“No a todos”) nunca fue incluido.

Actualización: una pequeña búsqueda en Google  revela que con un poco menos de pereza hubiese resuelto este problema hace muchos años.

Lo encontré (¡por fin!) vía Acceso directo.

lunes, 5 de enero de 2009

Búsqueda de errores y depuración: una historia, un poco de metodología y algunos consejos.

Último día laboral de este 2008. 7.20 de la mañana (¡sí señor!), ya despabilado y mate en mano frente a la pantalla. Mientras inicia Windows, el entorno de desarrollo y el proyecto (y un largo etc.) leo un auto-recordatorio de baja tecnología (un papel suelto sobre el teclado) que dice "ver incidente 1269". Me acuerdo del protagonista de Memento quien, como yo, tiene el Garbage Collector demasiado activo: no recuerdo de qué se trata el maldito 1269.

Resumamos esquemática y velozmente algo que en realidad es un poco más complejo, pero no viene al caso: vendo una combinación de "fichas" de diferentes valores preestablecidos, eligiendo el usuario la combinación deseada. La pantalla pide primero el importe, luego ofrece la lista con las distintas fichas disponibles donde el usuario indicará la cantidad requerida de cada una.

Hay un tipo de ficha que es el más vendido. Por lo tanto cuando el usuario ingresa el importe y lo confirma se presenta completado por defecto el cuadro correspondiente a este tipo con el importe traducido en cantidad.

Como el usuario puede cambiar los valores, al final se comprueba que la entrada (el importe) sea igual a la salida (el valor de las fichas) y si está todo ok, se graba y listo.

Ya tenemos la primera máxima:

Ver el cuadro completo antes de bajar a los detalles: luego de una leída rápida al reporte del incidente hay que abocarse en obtener "the big picture": la mirada del cliente (humano o no), determinar el papel de esta funcionalidad dentro del sistema y, sobre todo: saber cómo debería funcionar.

Una nota: el caso en particular puede variar, pero en general un reporte de error o incidente sólo describe una situación, que no debería aceptarse como un error sin más análisis. Por ello el siguiente paso es reproducir la situación y clasificarla (por ejemplo: "error del sistema", o "error del entorno de ejecución", "nueva funcionalidad", o "error en el reporte de error" -valga la redundancia- o etiquetas similares).

Un poco de manoseo con la pantalla en cuestión no dejó lugar a dudas: si yo ingresaba un importe imposible de vender en fichas (digamos $10,31 y yo tengo fichas de $1 cada una) el sistema redondeaba la cantidad ofrecida por defecto (en mi ejemplo ofrecería vender 10 u 11 fichas). Al confirmar la transacción se leía un bonito mensaje "la transacción no suma 0" (una excepción de negocio medio genérica que se aplica a un sinfín de situaciones). Hasta ahí iba bastante bien aunque pensé que podría mejorar el mensaje. Pero cuando retrocedí y corregí el importe y volví a avanzar... ¡crash bum pang! Un error no controlado rompía la mitad de la pantalla. Ok. Hay un error, no cabe duda.

Esto da para un poco de teoría: el primer mensaje fue una excepción (controlada), el segundo un error. Escribí un poco más sobre eso hace poco: Errores y excepciones parte I, parte II y parte III. Pero citemos así seguimos adelante:

[...] Entiendo que una excepción es una situación inusual en la ejecución del sistema, pero contemplada al momento de diseñar el sistema o de escribir el código. [...] Un error, a diferencia de la excepción, es una respuesta o estado no contemplado en el sistema. [...]

Es decir, que el dinero ingresado no coincidiera con el valor de las fichas que salían era algo contemplado, se estaba chequeando (aunque me molestara el mensaje). Pero el posterior aterrizaje poco sutil de la aplicación, digamos, fue resultado de algo no contemplado por nadie (espero).

Así que me puse a leer ese feo mensaje de error. Completo, con stack trace y todo. Aunque ud. no lo crea, esto es algo que poca gente hace. Y así es como nos llenan de reportes de error del tipo "La conexión a la base de datos se ha caído." o "Disk Full". Es decir, situaciones que están claramente descritas en ese mensaje... que nadie lee.

Pero no son sólo los usuarios. Cierta ansiedad profesional nos lleva a enchufar el depurador, reproducir la situación, concentrarnos en la línea que tira el error y empezar desde ahí (tratando desesperadamente de no ir a ningún otro lado, como si todos los errores estuviesen en la última línea que se ejecutó del código). Mucha de esa información está ahí, delante nuestro.

Un dato importante obtenido al leer el mensaje que explotó la aplicación fue, justamente, "El tipo de ficha ya se encuentra incluido en la transacción". Es decir, era un mensaje codificado por nosotros, no un error descontrolado. En algún lado del código la situación fue tratada como una excepción (es decir contemplada), pero la aplicación explotó igual.

El siguiente punto de análisis es ¿qué debería haber pasado? Para corregir un error primero tenemos que saber cómo nos hubiese gustado que termine la historia. Como todo en sistemas, se empieza por la salida. ¿A dónde quiero llegar?

Pensé un poco en la situación, ordenando los problemas cronológicamente:

  • En principio, me debería haber informado de que no se podía vender por ese importe cuando lo confirmé y no dejarme seguir hasta el final de la operación. Los errores de entrada se informan lo antes posible.

  • Después, al confirmar toda la operación, el mensaje podría haber sido algo así como "No puede conformar el importe indicado con las fichas disponibles" en vez de eso tan extraño de "La transacción no suma 0".

  • Para seguir, al ir hacia atrás y volver a intentar se ve que el sistema intentó ingresar a la operación el mismo tipo de ficha dos veces, o aún más probable, que no haya borrado lo que estaba antes de reintentar.

    Eso se deduce del segundo mensaje, "El tipo de ficha ya se encuentra incluido en la transacción". No puedo decir que vendo 5 fichas de $1 por un lado y otras 5 de $1 por el otro en la misma operación, tiene que detallarse una y sólo una vez cada tipo de ficha: son 10 fichas de $1.

    Una nota importante: mal por el front-end, que primero se olvidó de borrar y después no contempló la posibilidad de una excepción. Bien por el negocio que controló la situación salvando las papas del fuego al cancelar la operación y arrojar una excepción con un mensaje decente. Es como si hubiese gritado dramáticamente "¡no puedo hacer eso, soy demasiado bueno, prefiero morir!"). ¿O hubiesen preferido quedar mejor con el cliente, que no pase nada, ni reportes, ni llamadas desesperadas, ni nada y encontrarse a fin de mes con 10.000 ventas que no cierran?.

  • Pero ese último mensaje debería haberse mostrado prolijamente como el primero, sin embargo en la pantalla apareció como un error no controlado.

    Otra nota: si luego de este bodoque siguen con ganas de leer los artículos citados, verán que esta situación indica que una excepción lanzada en la capa de negocio hizo "explotar" a la capa de presentación porque debido a un error ella no se lo esperaba. El problema no es el mensaje, sino que la capa de presentación no lo esperara y mostrara correctamente.

Me gustaría que los líderes de proyecto que lean esto lo tengan en mente cuando en su próximo ataque de ansiedad (ya sé que uds. ponen la cara) pretendan que arreglemos "esa bobada de los centavos" en 10 o 15 minutos o renieguen de que "el sistema explotó por una boludez tontería (pero nosotros tenemos que aguantarlos, y no tenemos a nadie más para descargar tensiones... lo que me recuerda "Reacciones ante los errores en un sistema informático").

Como podemos ver, que el sistema explote por una bobada es de por sí un error grave que trasciende esa bobada.

Ante este tipo de situaciones tenemos dos alternativas: resolver la bobada, y luego la otra y la otra y la otra (porque bobadas hay muchas) o resolver el problema de fondo logrando que el sistema resista las bobadas dejándonos más tranquilos y con más tiempo para trabajar en lo que nos gusta.

Para ser más explícito y utilizar el ejemplo: hay una larga cadena de errores, pero el último es el peor. Si ese mensaje se hubiese mostrado correctamente en vez de hacer explotar la pantalla,

  • el usuario se habría dado cuenta de que con reiniciar la operación bastaba para seguir trabajando,
  • lo hubiese percibido como una desprolijidad menor y no como un error de la aplicación,
  • y así la prioridad de todo el asunto baja bastante, ¿no?

Por supuesto, es más fácil arreglar el problema puntual de los centavos que solucionar todo eso.

Pero por suerte no le explotó al cliente en producción sino a nuestro equipo de pruebas (bien por ellos) con lo cual en vez de nervioso me sentía contento y aliviado. La misma sensación que debe tener un acróbata cuando tras fallar una pirueta aterriza suavemente en su red de seguridad.

No lo aclaré antes porque le resta dramatismo a todo.

Para finalizar:

  • ¿Programador principiante? Mira la línea en la que saltó el error y no entiende nada. Va hacia atrás y donde puede poner un "if" para evitar la situación lo enchufa, probablemente rompiendo otra cosa.
  • ¿Programador desganado? Arregla lo de los centavos (el primer problema) y todo lo demás desaparece... por un rato.
  • ¿Programador apurado? Arregla el último problema (el del mensaje) y manda el arreglo. Deja los demás registrados detalladamente con una solución propuesta para después.
  • ¿Yo en el último día de trabajo del año? En apenas 9 horitas lo tengo todo resuelto, cuando alguien me pida explicaciones le paso un link a este post, aunque seguramente no llegue al final.

¿Y cómo se corrige eso? Del último al primero:

  • que el mensaje de excepción no explote la pantalla (y lo pruebo),
  • que borre la basura de la operación incompleta evitando que tire ese mensaje (y lo pruebo),
  • cambiando el mensaje al final de la transacción para que diga claramente que no puede vender ese importe en fichas porque no hay forma (y lo pruebo),
  • y por último agregando un control para que controle esto apenas ingresado el importe (y lo pruebo).

Y así, mi catedral no sólo es más bonita, también es más resistente.

Un tip: vean que de esta manera voy probando todos los arreglos a medida que los voy implementando con el mismo caso de prueba. Si empiezan por el final, luego probar todo es un problema.

Espero que hayan llegado hasta aquí leyendo todo, despiertos y con ganas de vivir...

Ah, por cierto, cuando volvía para casa a las 18.00 me dí cuenta de un pequeño detalle que introduje en el último arreglo: si quiero vender $10.50 y tengo fichas de $1 y de $0.50 (operación 100% válida) pero tengo como predeterminada la ficha de $1 el sistema va a tratar de proponer $10.50 en fichas de $1, no va a poder y por obra y gracia de mis controles prematuros va a trabar toda la operación sin darle posibilidad al usuario de modificar las cantidades.

En resumen: corregí un buen par de problemas graves, pero por un pequeño error lo dejé, a ojos del mundo, peor que como estaba. ¡Ah! Y para eso tardé todo el día.

¿Me acordaré de corregirlo cuando vuelva? Seguro que sí, porque ese día es hoy y alguien me va a avisar. Magias de la programación de posts.

lunes, 29 de diciembre de 2008

Bad Usability Calendar.

Bad Usability Calendar: 12 consejos sobre lo que no debemos hacer al diseñar un front-end presentados con mucho humor.

Visto en webmaster libre.

lunes, 22 de septiembre de 2008

El usuario.

En principio definamos claramente usuario dentro del contexto de este post, para evitarnos problemas: usuario es el que opera el sistema en una situación real para alcanzar un objetivo determinado que coincide con el que fue requerido al desarrollar el sistema.

Mi definición tiene sus vericuetos: un analista probando una instalación del sistema no es un usuario, ya que su objetivo es el de encontrar errores, por más que esté en un entorno real. No es el líder del equipo presentando el producto, no es un hacker que intenta romperlo o extraerle información. Tampoco es uno de los empleados si simplemente lo está "explorando" para "familiarizarme un poco con él", ni es un cualquiera que lo ha abierto por equivocación, ni siquiera una persona que por desconocimiento quiere utilizarlo para algo para lo que no fue diseñado (ej.: el gerente entra al sistema de emisión de facturas (orientado hacia lo operativo) buscando saber el total de facturación de un cliente).

La definición también descarta los casos de de fallos en la interpretación o definición de los requerimientos. En definitiva, se acota el sinfín de situaciones posibles a aquéllas en las que el usuario y el sistema "quieren hacer lo mismo".

Un buen desarrollador siempre presente la siguiente máxima (hay muchas variaciones, pero ésta es la que viene más al caso):

El usuario es tonto o malicioso a menos que se demuestre lo contrario.

He tachado malicioso porque fue descartado por la definición anterior.

Entonces... ¿el usuario es tonto? ¡Qué novedad! pensará cualquier desarrollador. El que no lo sea tal vez se sienta ofendido. Lo siento, la verdad duele. El usuario es tonto. Siempre.

Tenemos un sistema interno de carga de horas. Es bastante nuevo, y muy simple. Por suerte en esta empresa no somos muy perseguidos con el horario (siempre y cuando las cosas más o menos salgan, claro) ni hay una cultura del tipo "qué-pasa-que-tus-ojos-no-están-sobre-la-pantalla", en donde suena una alarma cada vez que uno levanta la vista o no presiona una cantidad de teclas por minuto. Así que está exclusivamente orientado a cargar las horas a los proyectos correspondientes.

Cualquiera diría que tal sistema, sobre todo con el nivel de usuarios que tiene, no necesita de mayor asistencia para su uso. Error.

Es divertido ver como analistas funcionales, administradores de bases de datos, programadores de todo tipo y edad (entre los que me incluyo), líderes de proyecto, todos somos tontos a la hora de utilizarlo.

Y yo soy el primero, ojo. Basta hacer alt-tab desde el entorno de programación hacia este sistema para transformarme automáticamente en mi señora madre, que apunta y presiona compulsivamente cualquier forma cuadrada que aparezca más o menos por el centro de la pantalla.

  • Como usuarios, no hay mensaje ni sonido ni advertencia que pueda detenernos.
  • Cualquier sucesión de más de 10 caracteres con al menos un espacio en el medio (usualmente les decimos "mensaje" o "texto") pasa completamente desapercibida.
  • No importa si el monitor es de 15, 17, 19 o 40 pulgadas (en realidad cuanto más grande peor) sólo percibimos en un radio de 2cm con respecto al puntero del mouse, o en su defecto al centro de la pantalla.
  • Consecuentemente, si alguna vez leemos algo, difícilmente lo interpretemos en el contexto de la pantalla. Más probablemente lo interpretemos de acuerdo a lo que nosotros esperamos o queremos que suceda.
  • Somos incapaces de registrar nuestras propias acciones, ni siquiera las más inmediatas. No sabemos qué acabamos de tocar, ver, leer, escribir o mover.
  • Cualquier tipo de lógica deductiva (ni hablar de la inductiva) es anulado. Somos prueba-y-error. A veces ni siquiera eso, hacemos lo que creemos que hay que hacer y lo damos por hecho sin importar la respuesta del sistema.
  • A partir de la primera vez que logremos nuestro objetivo, repetiremos siempre la misma secuencia de acciones en forma automática. Hasta el más radical rediseño de pantalla sólo será percibido cuando impida que esa secuencia se complete. Si no lo impide, jamás nos daremos cuenta.
  • Ante cualquier cambio volvemos a 0, ya no sabemos utilizar el sistema. En realidad menos que 0, seguimos repitiendo acciones inútiles o contraproducentes, y probablemente estemos enojados. Recorreremos un largo camino para entender que ya no es como antes (llegaremos a 0) y luego volver a aprender.

Sí, ya sé "yo no hago eso", "yo no soy así"... vamos, no les creo. La diferencia entre un usuario experto y un novato es que el experto recurre a su experiencia para captar rápidamente convenciones y formas comunes, disminuyendo la necesidad de muchas de las secuencias de pruebas-y-errores que intenta el novato, quien además las ejecuta más lento.

¿Es así? ¿Por qué? Habrá una segunda parte.